Aula 8 — Hierarquia de Memória
Apresentação
A aula anterior terminou com uma pergunta em aberto: se memórias estáticas são mais rápidas e memórias dinâmicas são mais densas e baratas por bit, por que um computador não adota apenas uma dessas tecnologias? A resposta está na combinação de diferentes meios de armazenamento, cada qual ocupando um ponto distinto do compromisso entre velocidade, capacidade e custo. É essa combinação que esta aula sistematiza.
A ideia central tem um nome preciso: hierarquia de memória. Em vez de um único nível de memória, o computador empilha vários — do menor e mais rápido ao maior e mais lento —, e copia para os níveis de cima apenas a fração da informação que o processador está usando agora. Funciona porque programas reais não acessam a memória de forma aleatória: eles reutilizam o que já usaram e visitam posições vizinhas em sequência. Essa previsibilidade tem nome — localidade — e é ela que faz a hierarquia valer a pena.
Por que estudar isso em Organização de Computadores
Porque o desempenho de um computador não depende apenas da velocidade do processador, mas também da capacidade de fornecer instruções e dados no ritmo em que são solicitados. Padrões de acesso sequencial e reutilização de um conjunto de dados tornam perceptível o efeito da hierarquia. Nas próximas unidades, os conceitos de acerto, falha e taxa de acerto permitirão explicar por que a memória cache existe e como seu desempenho é avaliado.
Objetivos
Ao final desta aula você deve ser capaz de:
- Explicar por que a diferença de velocidade entre processador e memória principal obriga à existência de uma hierarquia de memória.
- Descrever os quatro níveis típicos da hierarquia — registradores, cache, memória principal e memória secundária — e o que cada um otimiza.
- Definir acerto e falha, e relacionar cada um aos níveis da hierarquia.
- Explicar a localidade temporal e a localidade espacial, e dar um exemplo de cada uma a partir do comportamento de um programa.
- Calcular a taxa de acerto de um nível da hierarquia a partir do número de acertos e do total de acessos.
- Calcular o tempo médio de acesso de um nível, a partir da taxa de acerto e dos tempos de acerto e de falha.
Conteúdo
1. O problema: o descompasso entre processador e memória
O cenário ideal — memória principal ilimitada e com tempo de acesso instantâneo — não existe na prática. Além disso, durante décadas, o desempenho dos processadores cresceu mais rapidamente do que a redução do tempo de acesso da memória principal, construída com DRAM, tecnologia mais densa e barata por bit que a SRAM, porém mais lenta.
A Figura 1 ilustra a ampliação histórica desse descompasso.
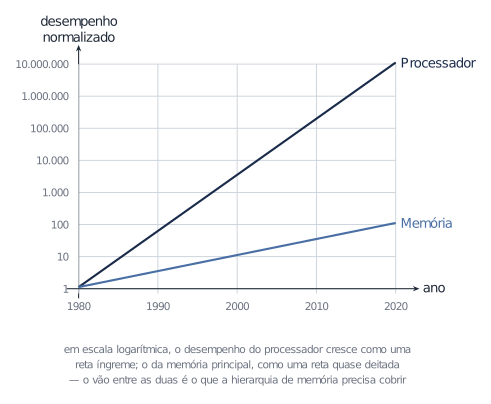
A consequência prática é a necessidade de estados de espera: ciclos de relógio em que o processador fica parado, aguardando que os dados ou instruções cheguem da memória.
Uma possibilidade seria substituir toda a memória dinâmica por memória estática, mais rápida. A Aula 7 mostrou por que essa opção não é economicamente viável: a célula SRAM ocupa mais área, apresenta menor densidade e tem custo por bit mais elevado.
A solução real, adotada por todo computador moderno, é combinar vários níveis de memória — de menor capacidade porém mais rápidos, perto do processador, a maior capacidade porém mais lentos, longe dele — e copiar para os níveis de cima apenas a informação mais relevante naquele momento.
Dois termos organizam o restante da aula:
- Acerto (hit): a informação solicitada é encontrada no nível consultado.
- Falha (miss): a informação não é encontrada no nível consultado e precisa ser obtida em um nível inferior, geralmente mais lento e de maior capacidade.
2. A pirâmide da hierarquia
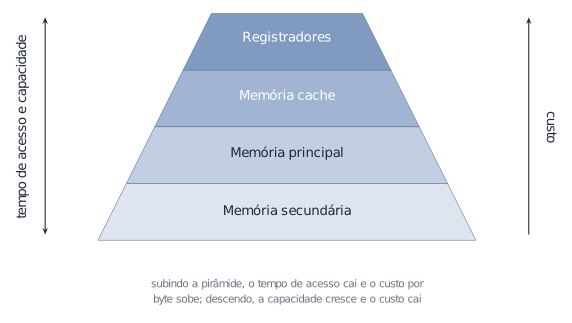
Os quatro níveis típicos, do topo (mais rápido, menor, mais caro) à base (mais lento, maior, mais barato):
A Figura 2 sintetiza os principais compromissos da hierarquia.
| Nível | Tecnologia | Ordem de capacidade | Ordem de latência | Gestão predominante | Unidade transferida |
|---|---|---|---|---|---|
| Registradores | circuitos no núcleo do processador | centenas de bytes a poucos KiB | fração de ns a poucos ns | compilador e conjunto de instruções | operandos ou palavras |
| Memória cache | SRAM | dezenas de KiB a dezenas de MiB | poucos ns a dezenas de ns | hardware | linhas de cache, em geral com dezenas de bytes |
| Memória principal | DRAM | GiB | dezenas a centenas de ns | controlador de memória; SO na memória virtual | rajadas/blocos no acesso físico; páginas na memória virtual |
| Memória secundária | Flash/SSD, disco magnético ou meio óptico | centenas de GiB a TiB | dezenas de µs em SSDs a vários ms em discos | controlador de E/S e sistema operacional | setores e blocos; arquivos na interface do SO |
Registradores. Internos ao processador e diretamente nomeados pelas instruções da arquitetura. O compilador procura manter neles os valores de uso imediato, embora o conjunto de instruções e o próprio programa também determinem quais registradores são acessados. As transferências envolvem operandos ou palavras, e não linhas de cache ou páginas.
Memória cache. Hoje construída na mesma pastilha do processador, entre os registradores e a memória principal, com tecnologia estática (SRAM). Movimentações entre cache e memória principal acontecem em quantidades fixas, chamadas linhas ou blocos, controladas por uma máquina de estados em hardware — sem intervenção do sistema operacional ou do compilador.
Memória principal. Construída predominantemente com DRAM — mais lenta que a SRAM, porém mais densa e barata por bit, como detalhado na Aula 7. No acesso físico entre cache e DRAM, o hardware transfere linhas por meio de rajadas. Quando a memória virtual precisa trazer dados do armazenamento secundário, o sistema operacional e o controlador de E/S movimentam páginas.
Memória secundária. É formada por dispositivos não voláteis, como SSDs, discos magnéticos e meios ópticos. Apresenta maior capacidade e menor custo por byte que os níveis superiores, mas suas latências variam amplamente: SSDs respondem em dezenas ou centenas de microssegundos, enquanto discos magnéticos podem exigir vários milissegundos. Na hierarquia apresentada, é o nível que preserva a informação sem alimentação.
3. Conceito de localidade
Resta explicar por que copiar informações para os níveis superiores produz ganho de desempenho, embora a primeira busca tenha custo adicional. Programas tendem a executar novamente os mesmos trechos de código em intervalos curtos e a acessar em sequência posições de memória próximas. Essas propriedades são denominadas localidade temporal e localidade espacial.
Localidade temporal
Durante a execução de um programa, posições de memória (dados ou instruções) já referenciadas tendem a ser referenciadas de novo em um curto intervalo de tempo.
- É observada tipicamente em laços de instruções, no topo de pilhas, em variáveis acumuladoras e em contadores. Um vetor só apresenta localidade temporal quando seus mesmos elementos são reutilizados em curto intervalo.
- É a propriedade que a memória cache mais depende para funcionar: se um dado é usado várias vezes seguidas, vale a pena mantê-lo copiado no nível rápido depois do primeiro acesso.
Localidade espacial
Durante a execução de um programa, se uma posição de memória é referenciada, as posições vizinhas tendem a ser referenciadas logo em seguida.
- É por isso que a informação é trazida da memória principal para a cache em blocos, e não palavra por palavra: o processador provavelmente vai precisar, em breve, dos dados ou instruções vizinhos ao que acabou de acessar.
- Linhas de cache frequentemente têm 32, 64 ou 128 bytes. Páginas de memória virtual costumam ter alguns KiB, embora o tamanho dependa da arquitetura e da configuração do sistema.
Quando há localidade, o custo de trazer um bloco para um nível superior pode ser amortizado por acessos subsequentes mais rápidos. Quando o espaço se torna necessário, uma política de substituição escolhe qual bloco deve ser removido; blocos modificados podem precisar ser escritos no nível inferior antes da remoção.
Um laço que soma os elementos de um vetor de 100 posições ilustra as duas localidades ao mesmo tempo: a instrução do laço (a soma) é executada 100 vezes seguidas — localidade temporal —, enquanto os dados acessados a cada iteração são posições consecutivas do vetor — localidade espacial.
4. Métricas de eficiência
Dois parâmetros medem quão bem um nível da hierarquia está cumprindo o seu papel.
Taxa de acerto
A taxa de acerto () é a razão entre o número de acessos atendidos pelo nível consultado e o número total de acessos a esse nível:
Quanto maior a taxa de acerto — e, por consequência, menor a taxa de falha —, menor tende a ser o tempo médio de acesso. A taxa depende do programa, do nível de cache, da política de substituição e do padrão de leituras e escritas. Isoladamente, porém, ela não informa quanto tempo custa uma falha.
Tempo médio de acesso
O tempo médio de acesso () pode ser expresso de duas formas equivalentes. Se representa o tempo total de um acesso que falha, então:
onde é o tempo total de um acerto. Na forma mais comum da literatura, define-se a penalidade de falha como o tempo adicional causado pela busca no nível inferior:
As duas expressões são equivalentes quando . Distinguir tempo total de falha e penalidade de falha evita contar o tempo de consulta ao nível atual duas vezes.
Exemplo resolvido: se ns, ns e :
Repare que, mesmo com 90% de acerto, o tempo médio (19 ns) é quase o dobro do tempo de um acerto isolado (10 ns) — os 10% de falhas, por custarem dez vezes mais, pesam desproporcionalmente na média. É esse efeito que torna a taxa de acerto tão sensível: cair de 90% para 80% de acerto, no mesmo exemplo, levaria o tempo médio a 28 ns, quase 50% pior.
Essa formulação pode ser aplicada recursivamente a vários níveis: a penalidade de falha de um nível inclui o acesso ao nível seguinte. Essa é a base da análise de hierarquias com múltiplos níveis de cache.
5. Para onde isso vai
Com as Aulas 7 e 8, o subsistema de memória está completo: como uma memória é construída (célula, matriz, sinais de controle, tecnologias) e como várias memórias se combinam em sistema (hierarquia, localidade, métricas de eficiência).
- Na Unidade 4 — CPU, os registradores do topo da pirâmide reaparecem como parte do caminho de dados, e o ciclo de busca-decodificação-execução vai depender diretamente do tempo de acesso à memória principal discutido aqui.
- O conceito de acerto e falha, e a métrica de tempo médio de acesso, são exatamente o vocabulário usado para dimensionar e avaliar uma memória cache — o próximo refinamento natural desta hierarquia, quando a disciplina voltar ao tema.
- A localidade espacial desta aula é o mesmo princípio que, nas Unidades 5 e 6, vai justificar por que buscar instruções em sequência da memória (em vez de saltos aleatórios) é o caso comum, e por que desvios de fluxo têm um custo de desempenho.
Exercícios (checkpoints)
Verificação rápida
1. Por que um computador não constrói toda a sua memória com a tecnologia mais rápida disponível (memória estática)?
- a)Porque memória estática é volátil e memória dinâmica não é
- b)Porque memória estática tem capacidade de armazenamento muito menor e custo mais alto pelo mesmo espaço físico, o que tornaria o sistema inviável em escala
- c)Porque memória estática não pode ser endereçada de forma aleatória
- d)Porque o processador só consegue se comunicar com memória dinâmica
- e)Porque memória estática exige refresh periódico, o que a tornaria mais lenta que a dinâmica
2. O que caracteriza uma falha (miss) em um nível da hierarquia de memória?
- a)Um erro de hardware detectado por paridade
- b)O conteúdo buscado não é encontrado naquele nível, sendo necessário buscá-lo em um nível mais baixo, mais lento
- c)O processador tenta escrever em uma posição protegida contra escrita
- d)O tempo de acesso excede o tempo de ciclo do processador
- e)A taxa de acerto do nível cai abaixo de 50%
3. Um programa percorre um vetor de 1000 posições em um laço, somando seus elementos a cada iteração. Qual propriedade de localidade explica por que os elementos do vetor, uma vez trazidos para a cache em blocos, tendem a já estar disponíveis quando acessados na iteração seguinte?
- a)Localidade temporal, porque o mesmo elemento é acessado repetidamente
- b)Localidade espacial, porque elementos vizinhos do vetor são trazidos juntos em um mesmo bloco, e o laço os acessa em sequência
- c)Localidade de instrução, porque o código do laço é pequeno
- d)Localidade de registrador, porque o índice do laço fica em um registrador
- e)Nenhuma das duas localidades se aplica a acessos a vetores
4. Em uma memória cache com taxa de acerto de 95%, tempo total de 2 ns em caso de acerto e tempo total de 40 ns em caso de falha, qual é o tempo médio de acesso?
- a)2 ns
- b)3,9 ns
- c)21 ns
- d)40 ns
- e)38 ns
5. Qual nível da hierarquia é nomeado diretamente pelas instruções da arquitetura, em vez de ser preenchido automaticamente com linhas ou páginas?
- a)Memória cache
- b)Memória principal
- c)Memória secundária
- d)Registradores
- e)Todas movimentam dados em blocos de tamanho fixo
Questões dissertativas
Explique por que a hierarquia de memória funciona — ou seja, por que copiar dados para um nível mais rápido, antes de eles serem efetivamente necessários de novo, resulta em ganho de desempenho e não em desperdício de tempo.
Um professor afirma que 'aumentar a taxa de acerto de uma memória cache melhora proporcionalmente o desempenho do sistema'. Avalie essa afirmação com a fórmula do tempo médio de acesso e diferencie redução absoluta do tempo médio e ganho relativo de desempenho.
Descreva o que significa 'localidade espacial' e explique por que ela justifica que a memória cache traga blocos inteiros de dados da memória principal, em vez de trazer apenas a palavra individual que o processador pediu.
Referências
Principais (essenciais)
- SILVA, Gabriel Pereira da; BORGES, José Antonio dos S. Arquitetura e organização de computadores: uma introdução. Rio de Janeiro: LTC, 2024. Recurso online — Acervo Virtual. Número de chamada: Ac.5063593
- Capítulo 4, Seção 4.3 — Hierarquia de memória (texto de referência desta aula)
Aprofundamento (opcionais)
-
STALLINGS, William. Arquitetura e organização de computadores. São Paulo: Pearson, 2024. Número de chamada: Ac.132127
- Análise aprofundada de hierarquias com múltiplos níveis de cache e políticas de substituição
-
DELGADO, José. Arquitetura de computadores. Rio de Janeiro: LTC, 2017. Recurso online — Acervo Virtual. Número de chamada: Ac.5013563
- O papel da hierarquia de memória no desempenho geral do sistema
-
WEBER, Raul Fernando. Fundamentos de arquitetura de computadores. Porto Alegre: Bookman, 2012. Número de chamada: 004.2 W375fuf Ac.113940
- Discussão clássica de localidade de referência e desempenho de hierarquias de memória
Pré-requisito
- Aula 7 — Memória Principal — a distinção entre memória estática e dinâmica, base para entender por que a hierarquia combina as duas.