Aula 9 — Processadores
Apresentação
Nas aulas anteriores, construímos memória a partir de circuitos e estudamos sua organização em níveis. Agora vamos acompanhar quem usa essa memória: o processador, ou CPU (Central Processing Unit, unidade central de processamento). Sua tarefa é executar instruções que transformam dados e determinam a sequência de operações de um programa.
A pergunta que orienta esta aula é: como uma instrução armazenada em memória se transforma em transferências entre registradores e em uma operação da ULA? O percurso vai do computador como sistema até o funcionamento interno da CPU, seguindo o capítulo 3 de Silva e Borges (2024).
Pré-requisitos: representação binária e complemento de dois da Aula 1, registradores, endereçamento de memória e hierarquia de memória.
Objetivos
Ao final desta aula, você deve ser capaz de:
- Relacionar programa armazenado, CPU, memória e entrada/saída, distinguindo von Neumann de Harvard.
- Identificar a função dos barramentos, da ULA, da unidade de controle e dos principais registradores.
- Rastrear o ciclo de instrução, incluindo uma alteração do fluxo pelo PC.
- Distinguir controle por hardware de controle microprogramado, e carry de overflow.
- Calcular endereços efetivos e identificar operandos em diferentes modos de endereçamento.
- Interpretar uma palavra multibyte em big-endian e little-endian.
- Traduzir expressões para cinco organizações de operandos, respeitando fontes, destinos e ordem das operações.
- Comparar RISC e CISC e calcular o tempo de CPU sem confundir frequência com desempenho.
Conteúdo
1. Programa armazenado e organização do computador
Um programa armazenado é uma sequência de instruções mantida em memória para ser buscada e executada pelo processador. A mesma máquina pode realizar tarefas diferentes quando carregamos outro programa, sem reconstruir seu circuito para cada tarefa.
Uma instrução de máquina é uma sequência de bits com significado definido pela arquitetura: somar, transferir um valor, comparar ou desviar, por exemplo. O opcode (operation code) identifica a operação; os demais campos podem indicar registradores, constantes ou maneiras de localizar os operandos, os valores lidos e o destino escrito pela instrução. Algumas dessas informações podem estar implícitas.
Os nomes ADD, LOAD e STORE são mnemônicos, uma representação textual mais legível que o código binário. O montador traduz uma linguagem de montagem para código de máquina. Linguagens de alto nível podem passar por compilação, interpretação ou execução em uma máquina virtual; esses caminhos não devem ser confundidos com a execução direta de uma instrução pela CPU.
Von Neumann e Harvard
No modelo von Neumann, instruções e dados compartilham a memória e, na organização simples, o caminho de acesso. Uma busca de instrução e uma leitura de operando disputam esse caminho, contribuindo para o gargalo de von Neumann. No modelo Harvard, memórias e caminhos de instruções e dados são separados, permitindo acessos independentes. A Figura 1 mostra essa diferença.
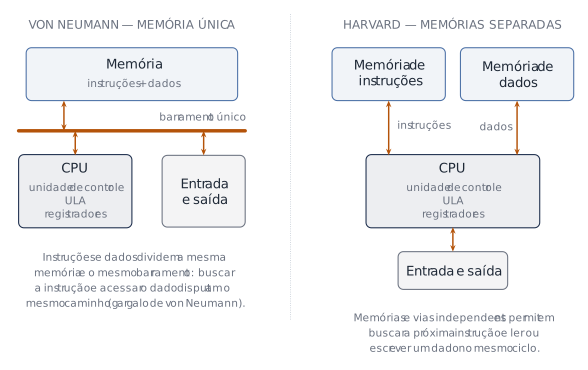
As duas organizações executam programas armazenados. Um sistema também pode combinar memória principal unificada com caches separadas para instruções e dados: a distinção depende do nível observado. Binário é a representação das informações; clock é o sinal periódico que coordena mudanças de estado. Nenhuma dessas duas características distingue, por si só, Harvard de von Neumann.
Modelo de barramento de sistema
O modelo reúne três blocos: CPU, memória e entrada/saída (E/S). A CPU agrupa unidade de controle, ULA e registradores; a memória armazena programas e dados; controladores e interfaces de E/S conectam periféricos ao sistema.
Um barramento é um conjunto de conexões e regras de transferência. Suas três funções devem ser distinguidas:
| Barramento | Informação transportada | Exemplo |
|---|---|---|
| Endereços | Posição ou dispositivo selecionado | Endereço do operando a ler |
| Dados | Conteúdo transferido, incluindo instruções | Bits da instrução ou do resultado |
| Controle | Operação, sincronização e coordenação | Leitura, escrita, resposta, interrupção |
O barramento de dados é bidirecional. No acesso comum iniciado pela CPU, ela fornece o endereço; outros agentes, como um controlador de DMA (Direct Memory Access, acesso direto à memória), também podem iniciar transferências quando autorizados. A arbitragem decide quem pode usar um recurso compartilhado, evitando conflitos.
Esse é um modelo funcional. Computadores podem usar várias interconexões e controladores integrados à CPU em lugar de um único barramento físico. A função de E/S continua existindo mesmo quando está distribuída em diversos componentes.
2. Dentro da CPU: caminho de dados, registradores e ULA
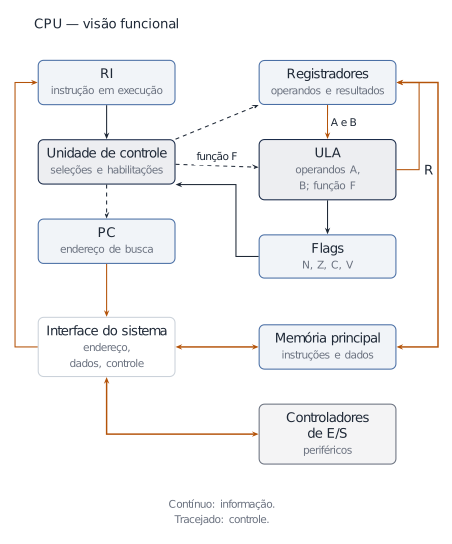
O caminho de dados, ou datapath, é o conjunto de registradores, ULA, multiplexadores e conexões que transporta e transforma valores. A unidade de controle (UC) seleciona caminhos, operações e momentos de escrita. A Figura 2 mostra as relações funcionais essenciais; omite caches, multiplexadores e detalhes do protocolo de memória.
Registradores e suas funções
Um registrador é uma pequena memória interna de acesso rápido. Registradores de uso geral guardam operandos, endereços e resultados; os especiais cumprem funções de execução.
| Nome | Função no modelo didático |
|---|---|
| R0, R1, … | Registradores de uso geral, quando a arquitetura os oferece |
| AC ou ACC | Acumulador: fonte e destino implícitos nas instruções aritméticas de uma arquitetura de acumulador |
| PC (Program Counter) | Endereço da próxima instrução a buscar; após a busca, aponta para a sucessora sequencial até ser alterado por um desvio |
| RI (Instruction Register) | Instrução buscada, mantida enquanto é decodificada e executada |
| SP (Stack Pointer) | Apontador da pilha, conforme a convenção da arquitetura |
| Flags | Bits de condição produzidos por operações que atualizam esses indicadores |
PC guarda um endereço; RI guarda uma instrução. Um desvio muda o PC, não troca arbitrariamente os bits do RI. A convenção usada aqui descreve o PC no ciclo sequencial didático; ao estudar uma ISA real, confira como ela define o PC durante a execução.
Uma chamada de procedimento preserva um endereço de retorno antes de transferir o fluxo. O retorno recupera esse endereço. Ele pode ficar na pilha ou em um registrador, dependendo da arquitetura. A pilha segue LIFO (Last In, First Out): o último elemento inserido é o primeiro retirado. Seu sentido de crescimento e a posição indicada por SP dependem da convenção escolhida. Ter uma pilha para chamadas não torna uma CPU uma arquitetura de operandos de pilha.
ULA: operandos, função, resultado e condições
A unidade lógica e aritmética, ULA — também chamada UAL; em inglês, ALU — transforma operandos binários. No esquema funcional, A e B são as entradas, F seleciona a função, R é o resultado e D reúne os códigos de condição. São nomes de sinais do modelo, não necessariamente registradores acessíveis pelo programa.
Entre as operações estão soma, subtração, AND, OR, XOR, deslocamentos e comparações. Multiplicação e divisão podem usar unidades específicas ou sequências de operações; nem toda ULA implementa diretamente todas as operações do conjunto de instruções.
| Flag | Significado usual |
|---|---|
| Z (Zero) | Resultado igual a zero |
| N (Negative) | Bit mais significativo do resultado; indica sinal negativo na interpretação em complemento de dois |
| C (Carry) | Na soma sem sinal, transporte além da largura do resultado |
| V (Overflow) | Resultado matemático com sinal fora do intervalo representável |
A definição de C na subtração e quais instruções atualizam flags variam entre arquiteturas. Alguns conjuntos de instruções fazem comparações e desvios sem um registrador global de flags.
Exemplo com 8 bits: 11111111 + 00000001 = 00000000, com transporte externo. Sem sinal, 255 + 1 não cabe: C = 1. Com sinal, −1 + 1 = 0 cabe: V = 0. Já 01111111 + 00000001 = 10000000 representa 127 + 1: C = 0, mas V = 1, pois +128 não cabe no intervalo de −128 a +127. O padrão armazenado é o mesmo tipo de resultado binário; a interpretação é que determina qual condição importa.
Largura da arquitetura: neste estudo, 8, 32 ou 64 bits se referem à largura inteira nativa dos registradores de uso geral e das operações correspondentes. Isso não determina automaticamente tamanho de instrução, endereço, barramento externo ou unidade vetorial. Uma CPU de 64 bits não implica instruções de 64 bits nem uso de todos os 64 bits para endereços físicos.
3. Ciclo de instrução: do endereço ao resultado
O ciclo de instrução é o conjunto de etapas necessárias para executar uma instrução. A Figura 3 separa etapas lógicas para tornar visíveis as decisões da CPU.
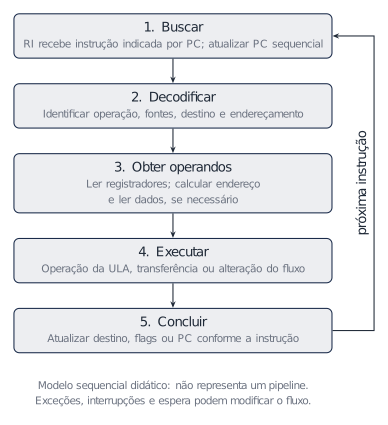
- Busca: a CPU solicita a instrução no endereço indicado por PC e a coloca no RI. Atualiza PC para a sucessora sequencial.
- Decodificação: a UC identifica opcode, fontes, destino e modo de endereçamento.
- Obtenção dos operandos: lê registradores e, se necessário, calcula um endereço e solicita dados à memória.
- Execução: realiza cálculo, transferência, comparação ou decisão de desvio.
- Conclusão: escreve o destino e atualiza as condições previstas pela instrução. Um desvio tomado substitui o PC sequencial pelo endereço de destino.
“Armazenar o resultado” não significa escrever sempre na memória: ADD pode escrever só em um registrador, STORE escreve um dado na memória e um desvio altera o fluxo. Ciclo de instrução não é ciclo de clock. Uma instrução pode consumir vários clocks; implementações com pipeline sobrepõem etapas de instruções diferentes. As etapas da figura não impõem um número universal de ciclos.
Exemplo: acompanhar PC e RI
Somente leitura — modelo didático, sem codificação de uma ISA real. Suponha memória endereçada por byte, instruções de exatamente 4 bytes, PC = 100 e R1 = 10. # indica constante e o destino é o primeiro operando. JMP é um desvio incondicional.
| Endereço | Instrução |
|---|---|
| 100 | ADD R1, R1, #5 |
| 104 | JMP 116 |
| 108 | ADD R1, R1, #99 |
| 116 | STORE C, R1 |
| Etapa | RI após a busca | PC após a busca | Efeito da execução |
|---|---|---|---|
| 1 | ADD R1, R1, #5 | 104 | R1 passa a 15 |
| 2 | JMP 116 | 108 | PC passa a 116 |
| 3 | STORE C, R1 | 120 | Memória na variável C recebe 15 |
A instrução em 108 não é executada nesse percurso. A atualização sequencial foi de 4 bytes porque definimos esse tamanho: não se deve usar PC + 1 ou PC + 4 para toda arquitetura sem conferir a unidade de endereçamento e o comprimento da instrução.
Um evento de interrupção é uma solicitação de atendimento, por exemplo de E/S; uma exceção decorre de uma condição detectada na execução, como uma instrução inválida. Esses eventos podem transferir o controle para uma rotina de tratamento, preservando o estado necessário ao retorno conforme a arquitetura. O ciclo também pode incluir espera por memória e estados de economia de energia.
4. Como a unidade de controle gera os sinais
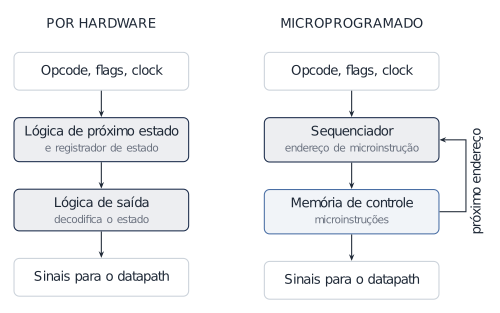
A UC usa a instrução, o estado da execução e condições relevantes para determinar sinais como: operação da ULA, seleção de um multiplexador, habilitação de escrita em registrador e solicitação de leitura ou escrita de memória. A Figura 4 compara duas estratégias de projeto.
Controle por hardware (hardwired)
Uma máquina de estados finitos mantém um estado atual e calcula o próximo. A lógica de saída gera sinais adequados ao estado e à instrução. O controle está descrito nas conexões e funções lógicas do circuito; alterações nessa organização normalmente exigem mudança de projeto.
Controle microprogramado
Uma memória de controle armazena microinstruções. Cada uma especifica sinais ou operações elementares e informações para determinar a próxima microinstrução. Um sequenciador percorre essa memória. A sequência que implementa uma instrução de máquina é seu microprograma.
A memória de controle e seu apontador não se confundem com a memória do programa e o PC. O programa pede, por exemplo, ADD; o microprograma pode coordenar várias transferências internas necessárias para realizar esse ADD.
No modelo de acumulador, uma sequência conceitual para ADD B seria: selecionar o endereço de B, solicitar leitura, disponibilizar ACC e o valor lido à ULA, selecionar soma e habilitar escrita em ACC. São micro-operações conceituais, não um microcódigo executável nem a imposição de um clock para cada passo.
| Estilo de microprogramação | Representação do controle | Compromisso principal |
|---|---|---|
| Horizontal | Campos largos, próximos dos sinais individuais | Mais bits por palavra; maior possibilidade de ativar ações compatíveis em paralelo |
| Vertical | Operações codificadas, que precisam de decodificação | Palavras mais compactas; decodificação adicional e possível aumento de passos |
Projetos podem combinar os estilos. Controle por hardware e microprogramação são escolhas de implementação, com associações históricas a RISC/CISC, mas sem equivalência obrigatória entre as classificações.
5. Modos de endereçamento: onde está o operando?
Um modo de endereçamento define como uma instrução localiza um operando. Endereço efetivo (EA) é o endereço calculado para acessar um operando em memória. Não confunda esse endereço com o valor armazenado nele.
Somente leitura — notação genérica dos exemplos: Mem[x] é o conteúdo da posição x, Rn é o conteúdo de um registrador, #k é uma constante imediata, (x) solicita conteúdo da memória e @(x) indica uma indireção adicional. Números sem prefixo estão em decimal. Essa notação não é código específico de Bisk-8, Sapiens, ARM ou x86; nem todos os modos existem em toda ISA.
| Modo | Exemplo | Efeito |
|---|---|---|
| Registrador | ADD R5, R4, R3 | R5 ← R4 + R3 |
| Imediato | ADD R5, R4, #8 | R5 ← R4 + 8 |
| Direto ou absoluto | ADD R2, R1, (100) | EA = 100; R2 ← R1 + Mem[100] |
| Indireto via registrador | ADD R5, R4, (R1) | EA = R1; R5 ← R4 + Mem[R1] |
| Indireto via memória | ADD R5, R4, @(100) | EA = Mem[100]; R5 ← R4 + Mem[Mem[100]] |
| Deslocamento | ADD R5, R4, 3(R0) | EA = R0 + 3; R5 ← R4 + Mem[R0 + 3] |
| Indexado | ADD R5, R4, (R2+R3) | EA = R2 + R3; R5 ← R4 + Mem[R2 + R3] |
| Pilha | ADD | Retirar duas fontes do topo e empilhar a soma, sem nomeá-las na instrução |
No imediato, a constante vem da própria instrução. No direto, a instrução fornece um endereço, que precisa ser consultado para obter o dado. No indireto via registrador, o registrador contém esse endereço. Na indireção via memória, é preciso primeiro ler o apontador e depois ler o dado.
Exemplo resolvido com um estado comum
Considere cada linha da tabela como uma instrução independente, partindo de R0 = 100, R1 = 104, R2 = 100, R3 = 4, R4 = 20 e dos valores Mem[100] = 104, Mem[103] = 7, Mem[104] = 10.
| Fonte a somar a R4 | EA, se houver | Valor da fonte | Resultado da soma | Leituras de dados/apontadores em memória |
|---|---|---|---|---|
R3 | — | 4 | 24 | 0 |
#8 | — | 8 | 28 | 0 |
(100) | 100 | 104 | 124 | 1 |
(R1) | 104 | 10 | 30 | 1 |
@(100) | 104 | 10 | 30 | 2 |
3(R0) | 103 | 7 | 27 | 1 |
(R2+R3) | 104 | 10 | 30 | 1 |
A última coluna exclui a busca da instrução e conta leituras lógicas de valores/apontadores, não transações físicas de DRAM. A cache pode atender essas leituras. Na indireção, Mem[100] = 104 é o endereço usado na segunda leitura, não o operando final.
Deslocamento é útil para acessar campos de uma estrutura; indexação, para percorrer vetores. Se a memória é endereçada por byte e cada elemento ocupa 4 bytes, o elemento de índice i exige base + 4 × i, não apenas base + i. A multiplicação pode ser feita pelo programa ou por um modo de endereçamento que admita escala.
6. Ordenação dos bytes: big-endian e little-endian
Endianness é a ordem dos bytes de um valor multibyte na memória. Em big-endian, o byte mais significativo ocupa o menor endereço. Em little-endian, é o menos significativo que ocupa esse endereço.
Armazene o valor hexadecimal de 32 bits 0x12345678 a partir de 0x1000. Cada posição da tabela contém um byte, também em hexadecimal:
| Endereço crescente | Big-endian | Little-endian |
|---|---|---|
0x1000 | 12 | 78 |
0x1001 | 34 | 56 |
0x1002 | 56 | 34 |
0x1003 | 78 | 12 |
Carregar os quatro bytes com a convenção correta recupera o mesmo valor. A ordem dos bytes muda; a ordem dos bits dentro de cada byte permanece a mesma. Um acesso isolado a um byte também não exige inverter nada.
A distinção aparece ao interpretar arquivos binários, protocolos e dumps de memória (listagens dos bytes armazenados). Se alguém interpretar 78 56 34 12 como big-endian, obterá 0x78563412, um valor diferente. Em formatos com unidades de vários bytes, como UTF-16 e UTF-32, a ordem também precisa ser definida. Um BOM (Byte Order Mark) pode sinalizar a ordem quando o formato ou protocolo o admite; a convenção do arquivo deve ser respeitada independentemente da CPU que o lê.
7. Cinco arquiteturas segundo a localização dos operandos
Essa classificação observa como as instruções aritméticas nomeiam suas fontes e destinos, não quantos registradores físicos existem dentro da CPU. Mesmo uma operação memória-memória precisa de armazenamento temporário interno para ser implementada.
Vamos realizar C = A + B, com A = 10 e B = 5. Todos os exemplos são somente leitura e usam pseudo-instruções genéricas. A, B e C são posições de memória; LOAD copia o conteúdo da posição, STORE grava um valor nela. Quando há três operandos, a ordem é destino, fonte 1, fonte 2. As organizações abaixo são modelos didáticos; uma ISA real pode combinar formatos.
Pilha
Fontes e destino da operação aritmética estão implícitos no topo da pilha. ADD tem zero operandos explícitos; PUSH e POP ainda precisam identificar a transferência neste modelo.
PUSH A
PUSH B
ADD
POP C
| Depois de | Pilha, da base para o topo | Mem[C] |
|---|---|---|
PUSH A | 10 | Não alterada |
PUSH B | 10, 5 | Não alterada |
ADD | 15 | Não alterada |
POP C | Vazia | 15 |
O topo pode ser mantido em registradores, com o restante da pilha em memória. TOS (Top of Stack) designa o topo; SP acompanha a estrutura segundo a convenção da máquina. Para operações não comutativas, a ordem é essencial: nesta aula, DIV retira primeiro o divisor do topo, depois o dividendo, e empilha dividendo / divisor.
Acumulador
ACC é fonte e destino implícitos; a instrução aritmética nomeia o outro operando.
LOAD A
ADD B
STORE C
O percurso é ACC ← 10, depois ACC ← 10 + 5 = 15, por fim Mem[C] ← 15. O destino implícito economiza bits de codificação, mas valores que precisam sobreviver ao próximo cálculo podem exigir armazenamento temporário.
Memória-memória
As duas fontes e o destino podem ser posições de memória, explícitos na mesma instrução.
ADD C, A, B
Ela lê A e B, soma e grava C. Há uma instrução, mas pelo menos duas leituras e uma escrita de dados nesse modelo lógico. Compactar a sequência de instruções não elimina o trabalho nem os acessos necessários para realizá-la.
Registrador-memória
Uma operação pode combinar um registrador e uma fonte em memória. No exemplo de dois operandos, o registrador é simultaneamente fonte e destino.
LOAD R1, A
ADD R1, B
STORE C, R1
R1 recebe 10; ADD lê B e atualiza R1 para 15; STORE grava C. Diferentemente do acumulador, o programa pode escolher o registrador que participa da operação.
Registrador-registrador (load/store)
As instruções aritméticas operam em registradores. LOAD e STORE transferem dados entre registradores e memória no modelo básico.
LOAD R1, A
LOAD R2, B
ADD R3, R1, R2
STORE C, R3
R1 recebe 10, R2 recebe 5, R3 recebe 15 e C recebe 15. ADD não lê um operando na memória. A busca de suas instruções continua necessária: load/store restringe o acesso a dados pelas operações aritméticas, não elimina a busca do programa. Extensões de ISAs reais podem oferecer outras operações de memória, como atômicas.
Comparação dos modelos
| Modelo | Fontes da soma | Destino | Operandos explícitos no ADD apresentado | Instruções para C = A + B |
|---|---|---|---|---|
| Pilha | Topo da pilha | Pilha | 0 | 4 |
| Acumulador | ACC e memória | ACC | 1 | 3 |
| Memória-memória | Memória | Memória | 3 | 1 |
| Registrador-memória | Registrador e memória | Mesmo registrador | 2 | 3 |
| Registrador-registrador | Registradores | Registrador | 3 | 4 |
Nos cinco exemplos há duas leituras e uma escrita das variáveis em memória. Esse total não inclui busca das instruções nem acessos adicionais da implementação da pilha. O ganho de usar registradores aparece especialmente ao reutilizar valores em várias operações, evitando transferências repetidas. O número de instruções sozinho não informa tempo de execução nem tamanho do código em bytes.
8. RISC, CISC e o que determina desempenho
A ISA (Instruction Set Architecture, arquitetura do conjunto de instruções) define o contrato visível ao programa: operações, registradores, formatos, endereçamento e comportamento. A microarquitetura é a organização interna que implementa esse contrato. CPUs com a mesma ISA podem ter diferentes caches, pipelines e unidades de execução.
RISC (Reduced Instruction Set Computer) e CISC (Complex Instruction Set Computer) descrevem tradições de projeto de ISA. A comparação é útil como tendência, não como regra absoluta de desempenho.
| Aspecto | Tendência RISC | Tendência CISC |
|---|---|---|
| Operações | Operações regulares, com separação entre cálculo e acesso a dados | Algumas instruções combinam várias ações e acesso a dados |
| Formatos | Mais padronizados | Maior variedade de comprimentos e formatos |
| Endereçamento | Conjunto mais regular de modos | Maior diversidade de modos |
| Operandos aritméticos | Organização load/store | Possibilidade de operandos em memória |
| Exemplos de famílias | ARM, RISC-V, Power | x86 e sua extensão de 64 bits, x86-64 |
RISC não significa “qualquer instrução termina em um clock”. Falhas de cache, dependências, desvios, multiplicação e divisão podem mudar os ciclos gastos. CISC não impede pipeline. Pipeline sobrepõe etapas, e execução superescalar permite trabalhar com mais de uma instrução por ciclo quando há recursos e independência suficientes.
Formatos regulares também não significam comprimento único em toda configuração: RISC-V admite instruções comprimidas de 16 bits junto às de 32 bits (manual da ISA, introdução). O conjunto básico RV32I explicita o modelo load/store (manual RV32I, seção Load and Store Instructions).
Implementações Intel x86 decodificam instruções em micro-operações internas, e algumas operações usam microcódigo. Isso mantém o contrato x86 visível ao programa; não o transforma automaticamente em outra ISA pública (documentação Intel sobre micro-operações). A distinção ISA/microarquitetura explica por que classificações históricas não bastam para descrever toda a implementação.
Tempo de CPU, CPI e frequência
O CPI médio é o número total de ciclos consumidos dividido pelo número de instruções dinamicamente executadas, incluindo repetições dos laços. IPC é a razão inversa, instruções por ciclo, quando medido sobre a mesma execução e os mesmos ciclos.
Aqui, é a contagem de instruções executadas, é a duração de um ciclo e é a frequência. Tempo de CPU não é necessariamente o tempo total percebido pelo usuário: espera por E/S e outros processos também pode contribuir para o tempo decorrido.
Exemplo resolvido — dois projetos hipotéticos executando a mesma tarefa:
| Projeto | Instruções executadas | CPI médio | Frequência | Tempo de CPU |
|---|---|---|---|---|
| X | 1 milhão | 2 | 2 GHz | 1 ms |
| Y | 1,5 milhão | 1 | 2 GHz | 0,75 ms |
X consome ciclos. Y consome ciclos. Apesar de executar mais instruções, Y termina antes: o ganho é , ou cerca de 33% mais desempenho, com 25% menos tempo. Esses números não representam processadores comerciais nem provam superioridade geral de uma família de ISA.
Aumentar f reduz o tempo se os demais fatores permanecerem iguais. A frequência é limitada por atrasos dos circuitos, energia e dissipação térmica; o CPI também depende do programa e da hierarquia de memória. Mais núcleos permitem paralelismo, mas acelerar uma tarefa exige trabalho que possa ser distribuído. Largura em bits, frequência, quantidade de núcleos e classificação RISC/CISC precisam de contexto para comparar CPUs.
Exercícios (checkpoints)
Tente responder antes de revelar o gabarito. Os exemplos continuam sendo somente leitura, com a notação genérica definida nesta aula.
1. No modelo desta aula, qual afirmação distingue corretamente PC de RI?
- a)PC guarda a instrução e RI guarda seu endereço.
- b)PC fornece o endereço de busca; RI mantém a instrução buscada.
- c)PC e RI guardam sempre o mesmo conteúdo.
- d)RI aponta para o topo da pilha.
- e)PC guarda o resultado da última soma.
2. No modelo registrador-registrador, de onde ADD R3, R1, R2 obtém as fontes?
- a)Das posições de memória cujos endereços são R1 e R2.
- b)Da pilha, implicitamente.
- c)Do conteúdo dos registradores R1 e R2.
- d)Dos valores imediatos 1 e 2.
- e)Sempre da memória principal, sem passar por cache.
Explique como programa armazenado permite mudar a tarefa do computador. Qual diferença entre von Neumann e Harvard afeta a busca de uma instrução enquanto se acessa um dado?
Compare ADD B em uma CPU de acumulador com sua realização por uma unidade de controle microprogramada. O que é instrução, o que é microinstrução e onde ficam o programa e o microprograma?
Em uma soma de 8 bits, determine o resultado armazenado e os flags C e V para (a) 250 + 10, interpretados sem sinal; (b) 120 + 10, interpretados com sinal. Justifique também Z e N a partir dos bits do resultado.
Considere R0 = 200, R1 = 204, R2 = 20, Mem[200] = 204, Mem[203] = 7 e Mem[204] = 10. Para ADD R5, R2, #8; ADD R5, R2, (200); ADD R5, R2, (R1); ADD R5, R2, @(200); ADD R5, R2, 3(R0), determine o operando final, o endereço efetivo quando existir e o resultado em R5. Avalie cada instrução de forma independente.
Uma palavra de 32 bits ocupa os endereços 0x2000 a 0x2003 com os bytes AB, CD, EF, 01 nessa ordem. Qual é seu valor em big-endian e em little-endian? Algum byte precisa ter seus bits invertidos?
Traduza C = A / (A + B) para as cinco arquiteturas. Use T como posição temporária quando necessário. Nesta questão, DIV faz divisão inteira de valores não negativos; o divisor deve ser diferente de zero. Na pilha, o topo é o divisor e o elemento abaixo é o dividendo. Confira com A = 12 e B = 4.
Traduza C = (A + B + C) / D para as cinco arquiteturas, preservando o valor original de C até sua leitura. Use divisão inteira de valores não negativos e D diferente de zero. Confira com A = 10, B = 5, C inicial = 9 e D = 4.
O projeto P executa 2 milhões de instruções com CPI = 1,5 a 3 GHz. O projeto Q executa 1,5 milhão com CPI = 2 a 2 GHz. Calcule tempo de CPU e IPC de cada um, determine o ganho de desempenho do mais rápido e explique por que menos instruções ou a classificação RISC/CISC não resolvem a comparação.
Referências
Principais (essenciais)
- SILVA, Gabriel Pereira da; BORGES, José Antonio dos S. Arquitetura e organização de computadores: uma introdução. Rio de Janeiro: LTC, 2024. Recurso online — Acervo Virtual. Número de chamada: Ac.5063593.
- Capítulo 3 — Organização do computador e do processador: §3.1 (von Neumann), §3.2 (barramento de sistema), §3.3 (funcionamento, controle, endereçamento e ordenação dos bytes), §3.4 (tipos de arquitetura) e §3.5 (RISC versus CISC).
- BRUSSO, Marcos José; PATRICIO, Diego Inacio. Organização do computador e do processador. Slides de aula, arquivo “05 Processador.pptx”, sem data indicada.
- Sequência de tópicos e exemplos de arquiteturas; expressões dos slides 57 e 58 retomadas nos checkpoints 8 e 9.
Aprofundamento (opcionais)
- STALLINGS, William. Arquitetura e organização de computadores. São Paulo: Pearson, 2024. Número de chamada: Ac.132127. Organização da CPU, controle e desempenho.
- DELGADO, José. Arquitetura de computadores. Rio de Janeiro: LTC, 2017. Recurso online — Acervo Virtual. Número de chamada: Ac.5013563. Organização do caminho de dados e execução de instruções.
- RISC-V International. The RISC-V Instruction Set Manual, Volume I: Unprivileged Architecture. Edição 20240411: introdução e RV32I, versão 2.1. Especificação concreta de formatos e do modelo load/store.
- Intel. CPU Metrics Reference, documentação do VTune Profiler, edição 2023. Micro-operações, decodificação e uso de microcódigo. Consulta técnica pontual para distinguir ISA e implementação.